引言
半导体行业的黄金时代建立在两条经典定律之上。
摩尔定律由戈登·摩尔于1965年提出,其核心观察是:集成电路上可容纳的晶体管数量约每两年翻一番。这一定律并非物理法则,而更像是一个自我实现的行业预言。它驱动整个产业持续缩小晶体管尺寸,从而在同等芯片面积上集成更多晶体管。
登纳德缩放定律由罗伯特·登纳德于1974年提出,为摩尔定律提供了物理实现的方法论。其核心原则是“恒定电场缩放”:当晶体管的沟道长度、宽度、氧化层厚度等所有几何尺寸等比例缩小为原来的时,工作电压也同步降为。
在摩尔定律和登纳德缩放定律有效期内,减小晶体管尺寸、增加晶体管密度的好处包括:
- 更小的晶体管具有更小的本征时延
- 密度更高,意味着信号传输距离减少,信号传输时延减少
大约从2005年起,登纳德缩放定律首先失效。其根源在于电压无法无限降低:当工作电压接近0.7–0.8V时,晶体管的亚阈值摆幅限制使得漏电流急剧增加,继续降压将导致开关比恶化到不可接受的程度。
与此同时,继续缩小晶体管物理尺寸的收益也急剧衰减:
- 速度层面:在长沟道时代,载流子迁移率与电场强度呈线性关系,本征延迟,缩小尺寸带来平方级收益。而在深亚微米的短沟道中,载流子发生速度饱和,,收益退化为线性级(相关推导见后文附录“晶体管的本征延迟”)。
- 物理层面:栅氧化层厚度已逼近原子尺度,量子隧穿效应导致栅极漏电成为不可忽略的稳定性问题来源。
- 经济层面:先进工艺节点的掩膜成本、极紫外光刻设备折旧与设计规则复杂度急剧攀升。
更为关键的是,影响处理器性能的矛盾主要方面已经发生了改变。数字电路由组合逻辑(执行布尔运算的门网络)与时序逻辑(保存状态的触发器)交替级联构成。芯片的最高工作频率由相邻触发器之间关键路径的延迟决定:
在微米时代,(晶体管开关延迟)占绝对主导,互连延迟可忽略不计。然而,随着工艺微缩,导线横截面积急剧缩小导致单位长度电阻显著增大,而线间距缩小又导致单位长度电容上升。两者的乘积不降反升,在现代工艺节点中已超越门延迟,成为关键路径延迟的主导分量。
路线:从几何缩放到时间缩放
传统摩尔定律的路径是间接的:通过缩小晶体管尺寸 → 降低单管延迟、缩短互连距离 → 最终降低系统延迟。当缩小尺寸这一中间手段耗尽潜力后,路线选择直接瞄准最终目标:系统的时间常数本身。
路线将系统延迟建模为各层级延迟的函数:
其中:
- :器件层,单晶体管的开关延迟。
- :电路层,标准单元与逻辑门的组织开销。
- :芯片层,布局布线引入的互连延迟。
- :系统层,多芯片互联与数据通路的整体延迟。
每一层的值,由该层自身的物理特性及其引入的组织与通信开销共同决定。
逻辑折叠:电路层优化的核心实践
逻辑折叠(Logic Folding) 是路线在电路层的核心实践,其定义为:将数字电路、模拟电路和存储电路划分到垂直堆叠的有源层中,遵循时间缩放原则,联合优化性能、功耗和面积。
传统芯片设计遵循平面假设,所有逻辑单元平铺在单一硅平面上,信号通过上方的金属层堆叠绕线传输。逻辑折叠从根本上打破这一假设,将原本分布于同一平面的关键路径逻辑,拆分并重构至两层(最终为更多层)垂直堆叠的有源芯片上,通过超细间距混合键合实现层间互连,见图1。

逻辑折叠的核心收益来源于物理拓扑的结构性改变:
- 布局维度:从二维(2D)变为三维(3D),逻辑不再摊大饼式展开。
- 互连方式:从“平面绕线”变为“垂直直连”,将原本绕行的长导线替换为较短距离的垂直路径。
这直接带来导线物理长度的大幅缩短,寄生RC乘积随之急剧下降,从而有效压缩芯片级的关键路径延迟。
逻辑折叠的收益并非自动获得,其实现受制于一个关键的几何参数:齿轮比(gear ratio)。齿轮比定义为垂直互连间距(混合键合间距,即上下芯片间连接柱子的密度)与平面互连间距(顶层金属间距,即芯片内部最密金属线的密度)之比:
这一比值本质上衡量的是三维垂直通信带宽与二维平面通信带宽的匹配程度。
当齿轮比较大时(例如 >3),意味着垂直“柱子”的密度远低于内部金属线的密度。芯片内部的高密度信号线不得不通过复杂的转接绕线汇聚到稀疏的垂直通道上,形成显著的“鸟笼式布线开销”,由此引入额外的RC延迟,可能完全吞噬折叠带来的收益。
因此,压低齿轮比是实现逻辑折叠收益的物理前提。实践中要求齿轮比低于3,而理想目标是齿轮比 ≈ 1。以当前顶层金属间距约为基准,这要求混合键合间距做到以下,并最终向亚微米级逼近。当齿轮比达到1时,垂直互连密度与平面互连密度完全一致,键合界面的转接绕线开销将彻底消失,逻辑折叠的理论收益方可全部兑现。
从的层级模型来看,逻辑折叠属于层的优化:它在晶体管和电路性能难以继续突破时,通过架构与物理布局的三维革命,继续降低系统总延迟。
结论
路线和逻辑折叠的提出,标志着芯片设计从几何缩放到时间缩放的范式转移。当摩尔定律和登纳德定律相继失效,追求更少时延的连接方式便成为延续性能提升的关键路径。这一转型仍面临诸多开放挑战:三维原生EDA工具链的构建、跨晶圆工艺偏差的补偿、垂直互连物理开销的精细核算,以及能耗与性能之间的权衡。
附录
(1)晶体管的本征延迟
物理上,信号通过晶体管所需要的时间(本征延迟,记为)为
其中为沟道长度,是电子的平均漂移速度。当电子漂移速度未达到饱和时,可表示为
而
即
所以晶体管的大小越小,时延成平方速度减小。当电子的漂移速度饱和后,速度接近恒定极限,此时
时延就只能随的减小成线性减小了。
(2)案例研究:简易CPU的逻辑折叠
本案例研究中的CPU指令集如下:
| 指令 | 操作码 | 位域结构 | 功能 | 操作说明 |
|---|---|---|---|---|
| ADD | 00 | 00 | rd | rs1 | rs2 | 寄存器相加 | R[rd] = R[rs1] + R[rs2] |
| LI | 10 | 10 | rd | imm | 装入立即数 | R[rd] = imm |
| BNER0 | 11 | 11 | addr | rs2 | 不相等则跳转 | if (R[0] != R[rs2]) 则 PC = addr |
将每条指令划分为5个时钟周期,每个时钟周期完成的工作见下表:
| 指令 | C0 (000) | C1 (001) | C2 (010) | C3 (011) | C4 (100) |
|---|---|---|---|---|---|
| ADD (00) | 将rs1, rs2的地址写入地址寄存器 | 读GPR (RAM) 内容 | 将GPR内容写入操作数寄存器(进行加法) | 将rd地址写入地址寄存器 | 将计算结果写入GPR (RAM) 中 |
| LI (10) | 将rd地址写入地址寄存器 | 将imm值写入GPR (RAM) 中 | 空 | 空 | 空 |
| BNER0 (11) | 将rs2、R0的地址写入地址寄存器 | 读GPR (RAM) 内容 | 将读出的内容写入到操作数寄存器中(进行比较) | 空 | 根据条件更新PC值 |
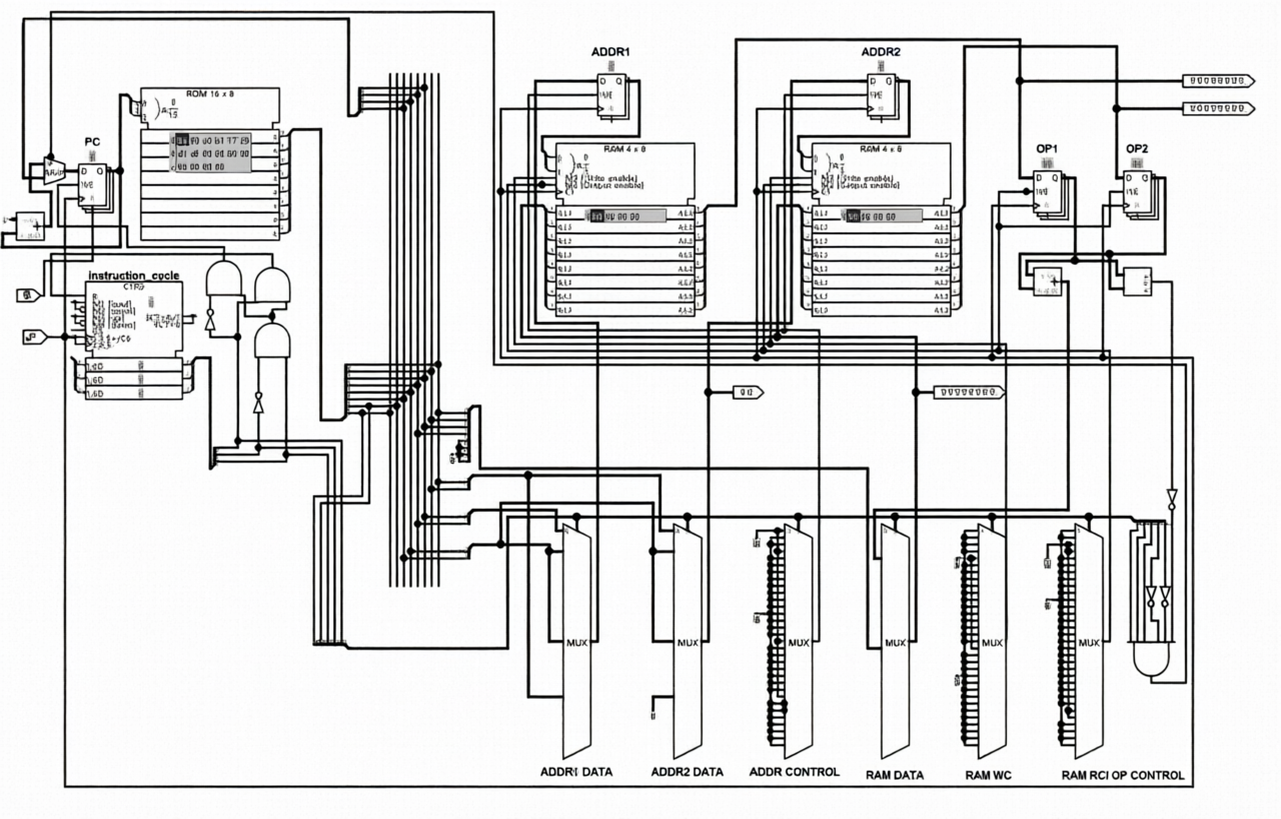
CPU架构图见图2,该CPU包括4个模块:
- Instruction:这个模块主要进行指令相关操作,例如取指和更新PC等操作
- GPR:GPR模块为通用寄存器模块
- ALU:ALU模块执行算术、比较操作
- Control:该模块为其他模块提供数据以及控制信号
将CPU进行逻辑折叠,结果见示意图3。
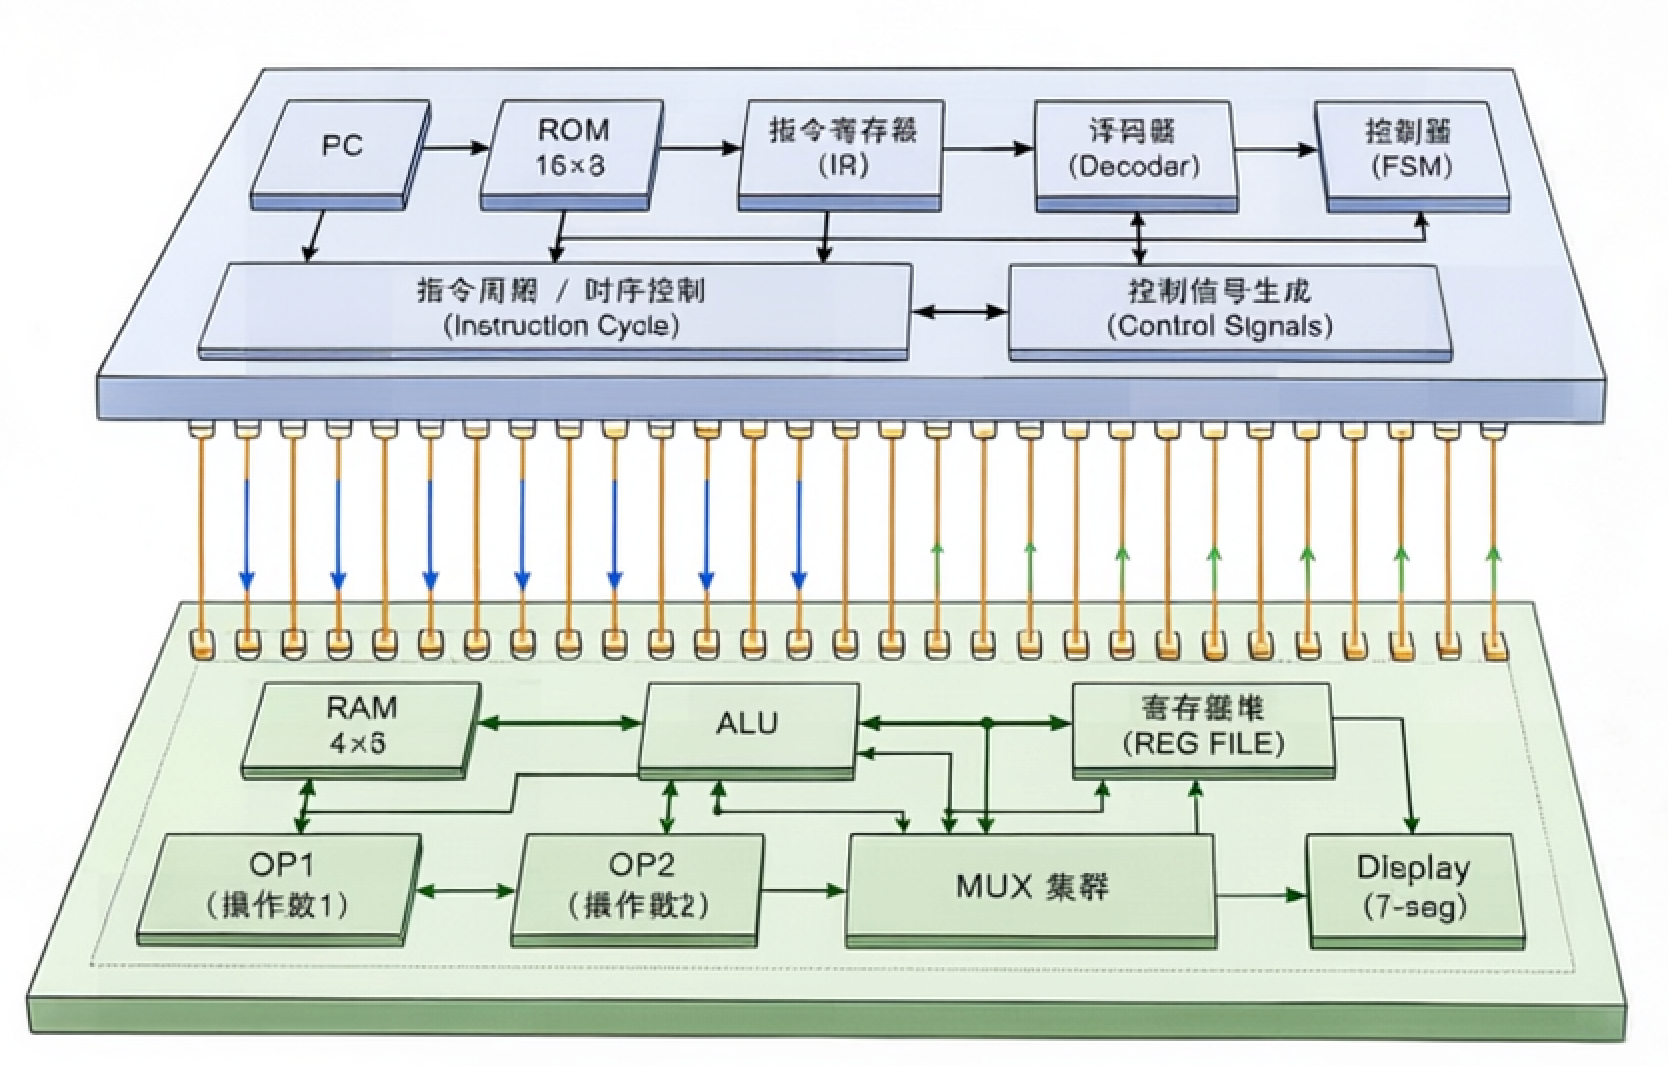
图3是一个示意图,并不严谨。在该折叠方案中,不同模块被分别置于上下两层有源芯片上。在传统二维布局中,二者之间的数据通路需绕行长导线,而在三维折叠架构下,信号通过垂直混合键合直连,物理连线长度大幅缩短,从而降低了关键路径上的互连RC延迟。这使得处理器在相同工艺节点下,能够运行在更高的时钟频率上。
(3) 一个更准确的逻辑折叠过程
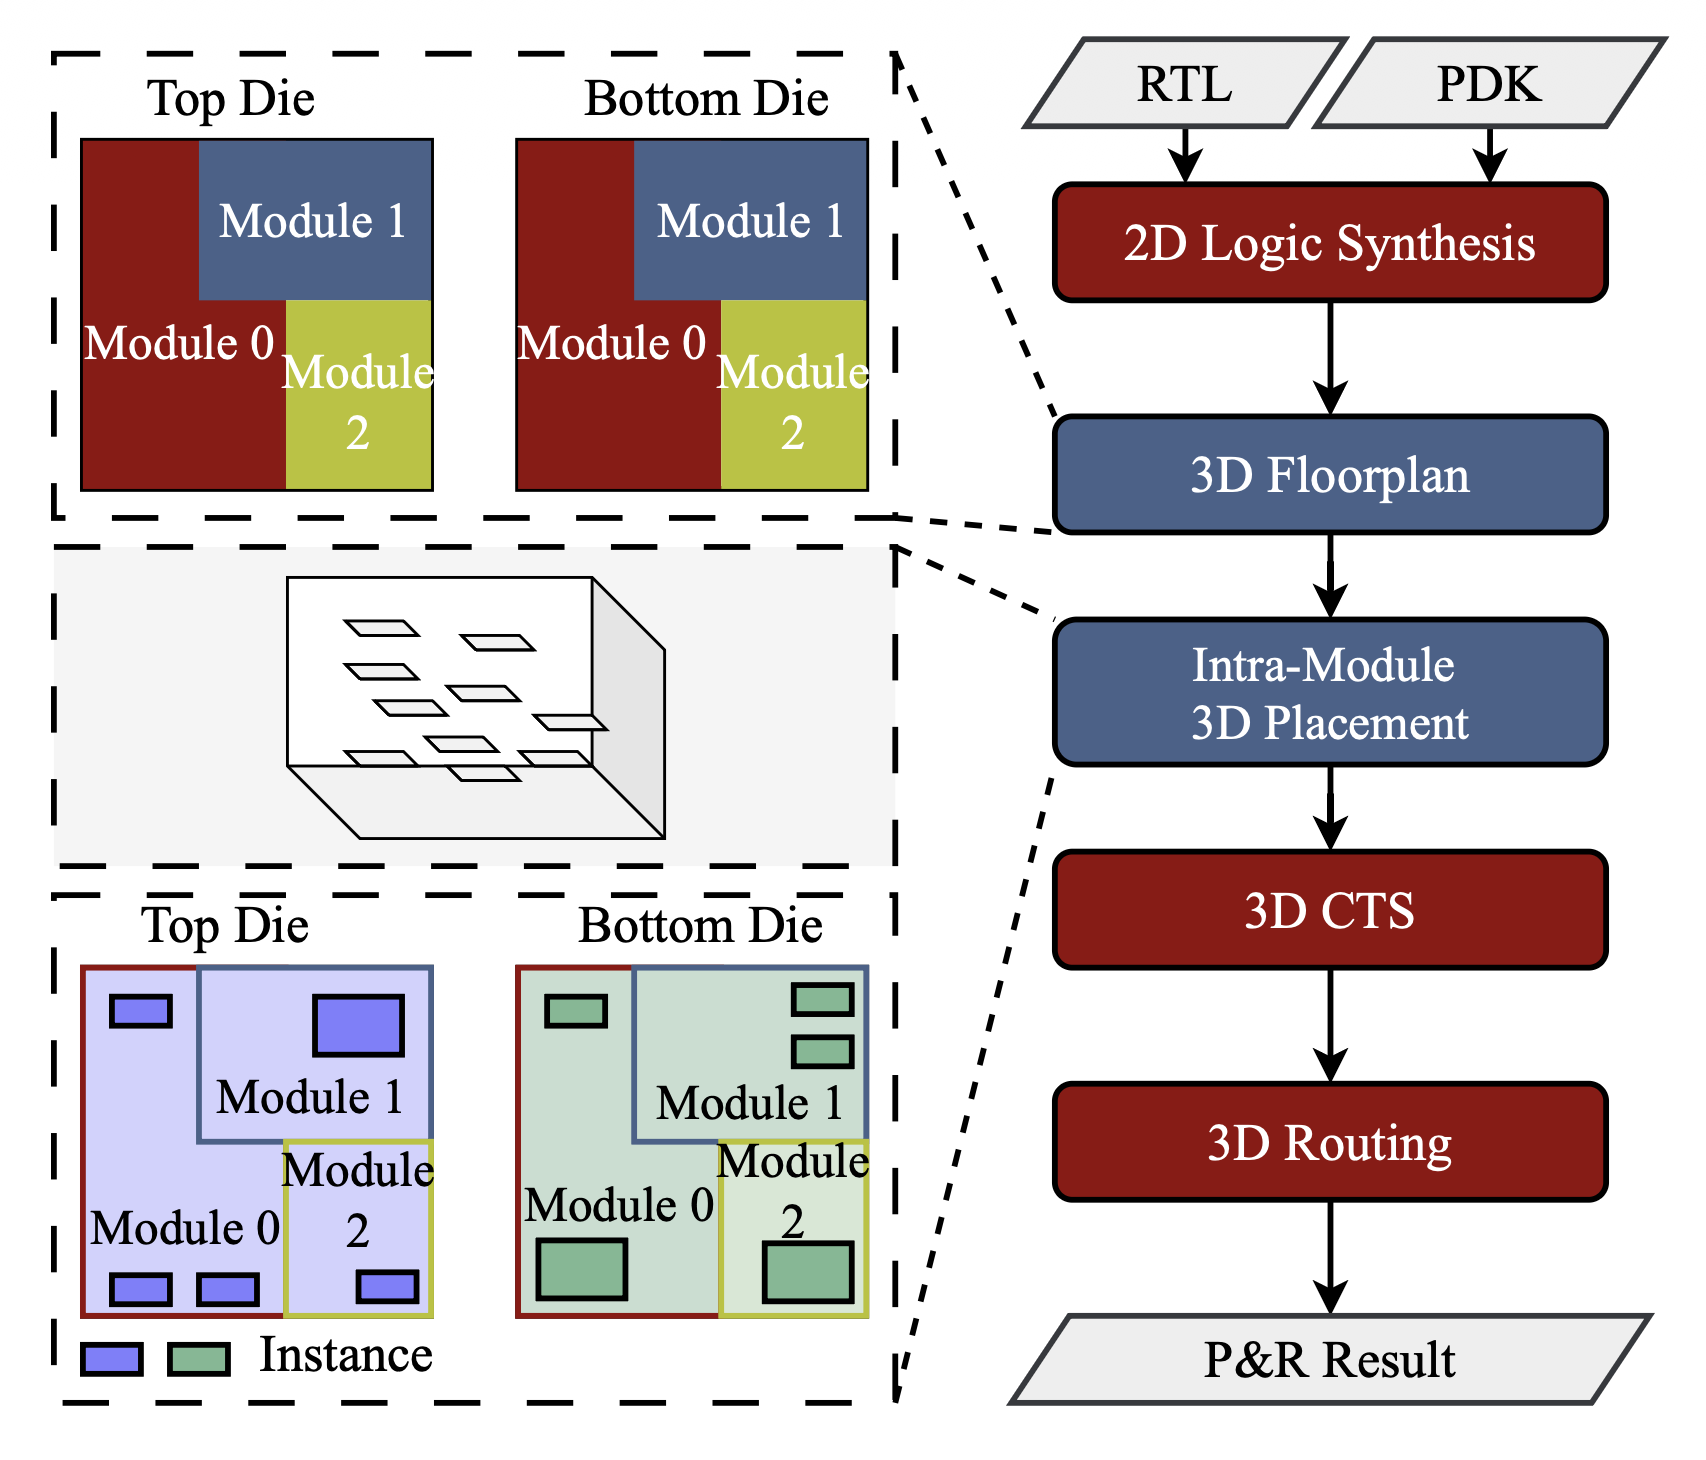
北京大学在逻辑折叠的EDA方面取得进展[2],图4展示了一个更准确的使用EDA进行逻辑折叠的过程。
参考文献
[1]. Tingbo He.A Time Scaling Theory for Multi-Layer Electronic Systems.中国科学院科技论文预发布平台.[DOI:10.12074/202605.00224]
[2]. 北京大学团队在面向“韬定律”3D逻辑折叠设计“真3D”EDA方向取得关键进展